
Слушай статията с гласа на Калина или я прочети спокойно по-долу.
Отвориш ли YouTube или TikTok, ще намериш стотици клипове как изкуственият интелект ще унищожи човечеството, ще ни вземе работата до един и вече „мисли“ зад гърба ни. Музиката е тревожна, гласът зад кадър шепне, а накрая винаги има призив да се абонираш.
Аз гледам на него иначе. Работя с техника всеки ден и за мен изкуственият интелект е инструмент. Чукът е продължение на ръката, очилата са продължение на окото, а калкулаторът смята вместо нас. Изкуственият интелект е продължение на мозъка: помага ни да мислим, пишем и търсим по-бързо. Но както всеки инструмент, той не решава сам какво да прави. Решава човекът, който го държи.
В тази статия ще обясня спокойно и подробно какво всъщност е изкуственият интелект, откъде идва, как „говори“ и на какви машини работи, включително как можеш да го пуснеш у дома. Ако искаш и техническите подробности, след някои части има сгънато каре „За техниците“.
Откъде идва: 75 години история
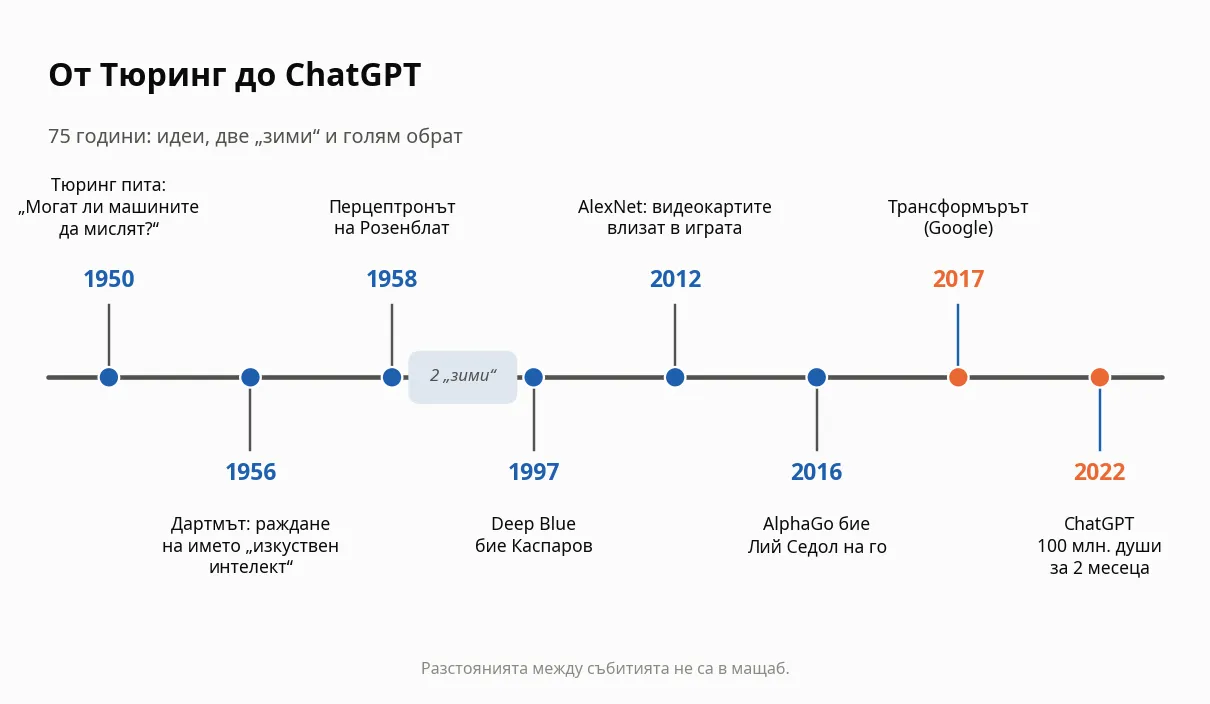
Изкуственият интелект не се е появил през 2022 г. с ChatGPT. Идеята е почти колкото самите компютри.
През 1950 г. английският математик Алън Тюринг пита в една статия: „Могат ли машините да мислят?“ и предлага игра. Ако човек си пише с някого и не може да познае дали отсреща е човек или машина, значи машината се справя.
През 1956 г. група учени се събира за едно лято в колежа Дартмът в САЩ. Там за първи път се използва изразът „изкуствен интелект“. Измисля го Джон Маккарти, един от организаторите на срещата.
През 1958 г. Франк Розенблат построява перцептрона, машина, която се учи да различава прости картинки. Това е прадядото на днешните невронни мрежи.
После идват две „зими“, през 70-те и в края на 80-те години. Обещанията били големи, компютрите слаби, а парите за изследвания свършили.
През 1997 г. компютърът Deep Blue на IBM побеждава световния шампион по шах Гари Каспаров. През 2012 г. мрежата AlexNet разпознава снимки много по-добре от всичко преди нея, обучена на две видеокарти за игри. Оттогава видеокартите стават двигателят на изкуствения интелект. През 2016 г. AlphaGo побеждава Лий Седол на го, игра, за която се смяташе, че е твърде сложна за машина.
Истинският обрат е през 2017 г. Изследователи от Google публикуват статия със заглавие „Вниманието е всичко, от което имаш нужда“ и описват нов вид мрежа, наречена трансформър. Буквата T в GPT идва точно оттам. На 30 ноември 2022 г. излиза ChatGPT и според изчисления на банката UBS за два месеца събира около 100 милиона потребители. Нито едно приложение дотогава не е растяло толкова бързо.
И малко българска гордост: първият електронен цифров компютър е създаден от Джон Атанасов, чийто баща е от село Бояджик край Ямбол. Без неговата идея за електронно смятане днес нямаше да има и изкуствен интелект.
Какво всъщност е изкуственият интелект
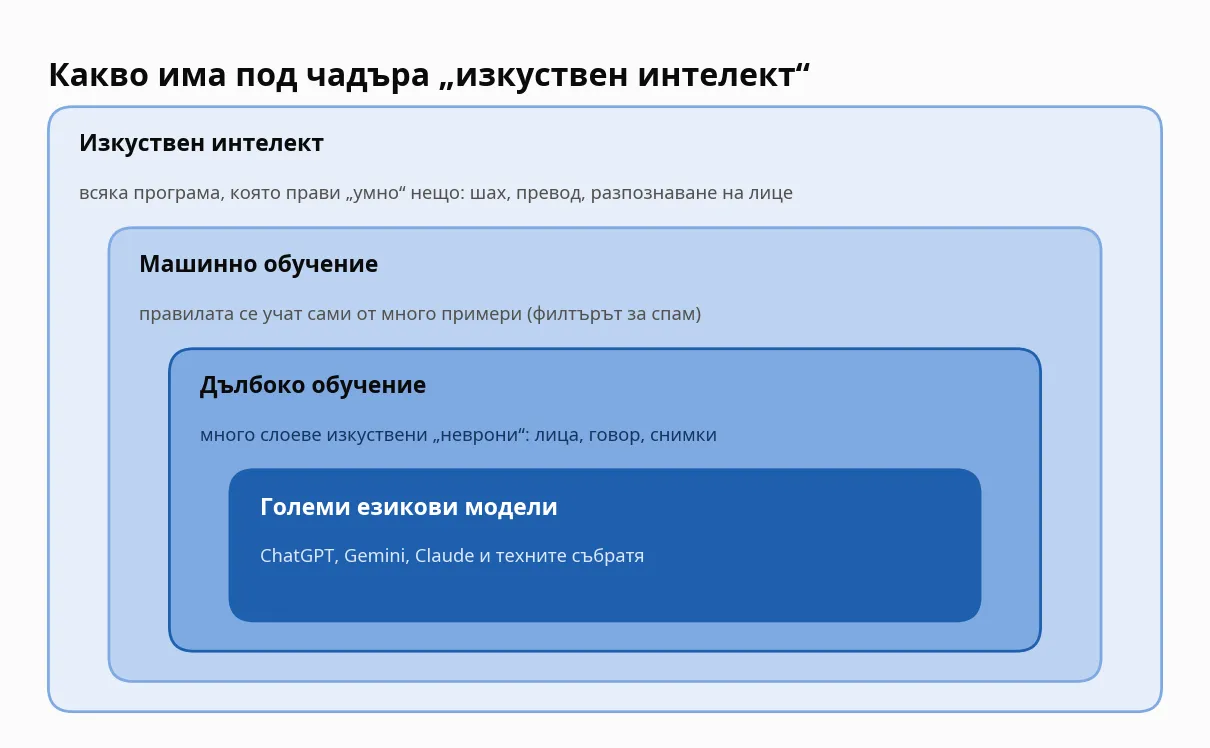
„Изкуствен интелект“ е голям чадър. Под него има няколко неща, вложени едно в друго като матрьошка.
- Изкуствен интелект е всяка програма, която прави нещо, което смятаме за „умно“: играе шах, разпознава лице, превежда.
- Машинно обучение е, когато програмата не следва правила, написани от човек, а сама открива правилата от много примери. Филтърът за спам в пощата ти е такъв.
- Дълбоко обучение е машинно обучение с много слоеве изкуствени „неврони“. То разпознава лица, говор и картинки.
- Големите езикови модели са най-новият клон. Това са ChatGPT, Gemini, Claude и техните събратя.
Важно е да се разбере едно: тези програми нямат съзнание, желания или чувства. Те са математика, много добре настроена математика, която работи върху огромни количества данни.
Какво е LLM, или как машината „говори“
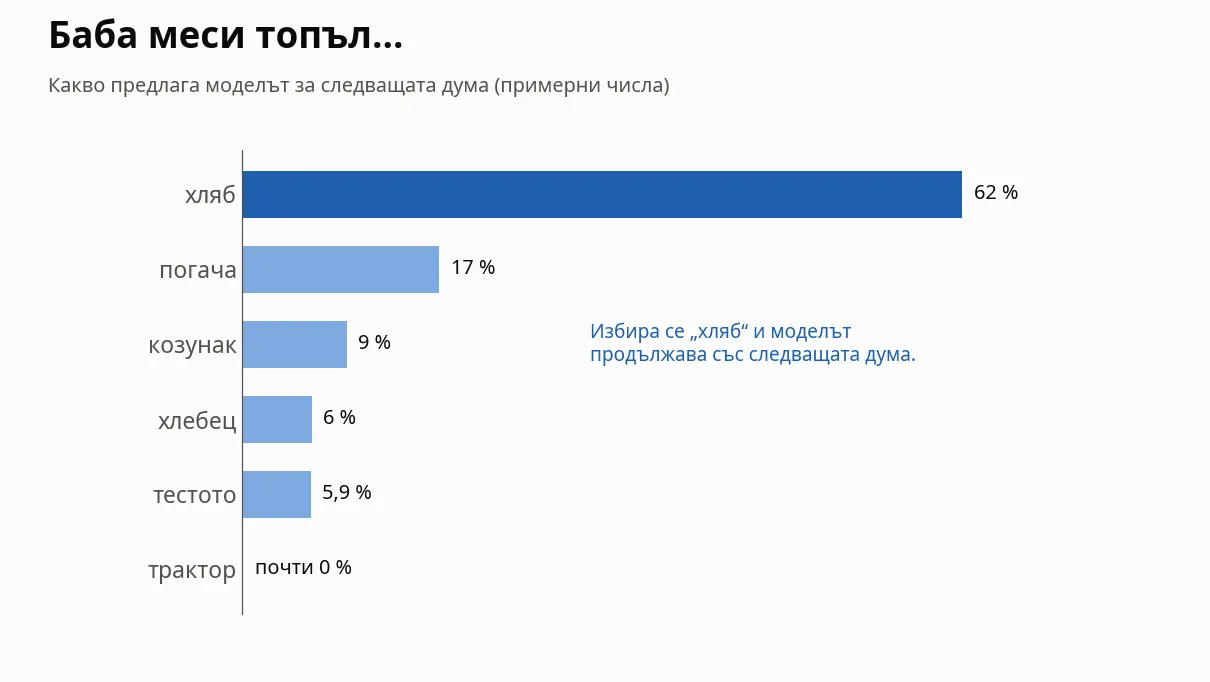
LLM идва от английското Large Language Model, „голям езиков модел“. Звучи сложно, но основната идея е проста: моделът е машина, която познава коя дума е най-вероятно да е следващата.
Помисли си за изречението „Баба меси топъл…“. Почти всеки българин ще довърши с „хляб“. Някой ще каже „погача“, рядко някой „козунак“. Никой няма да каже „трактор“. Ти не си научил това от правило в граматиката, а от хилядите пъти, в които си го чул.
Езиковият модел прави същото, но е „прочел“ огромна част от написаното в интернет, книги, статии и код. Когато му зададеш въпрос, той пише отговора дума по дума: всеки път пресмята вероятностите за следващото парче текст, избира едно и продължава. Цялото „умно“ поведение, обясненията, стиховете и програмите, се ражда от тази проста стъпка, повторена хиляди пъти.
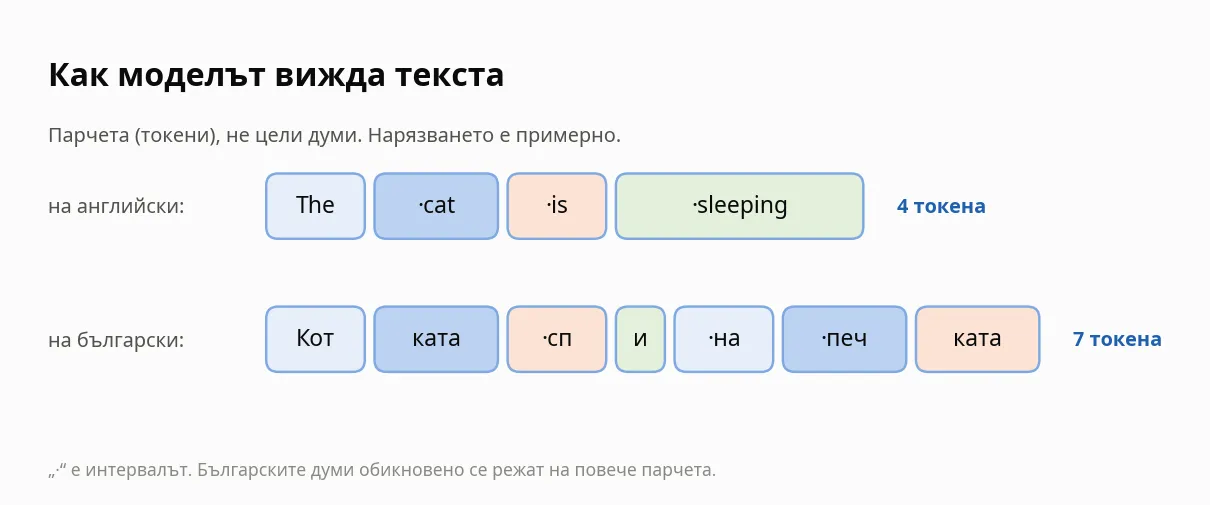
Моделът не вижда думите като нас. Той ги реже на парчета, наречени токени. Една кратка английска дума често е един токен, а българските думи обикновено се режат на две-три парчета, защото на български има по-малко текст в интернет. Затова някои модели говорят малко по-тромаво на български, отколкото на английски.
🔧 За техниците: Токени, параметри и „вниманието“
Токенизаторът (най-често BPE, Byte Pair Encoding) е речник от десетки до стотици хиляди парчета, събрани статистически: най-честите поредици от букви стават един токен. Всеки токен се превръща в дълъг вектор от числа (embedding), който описва „смисъла“ му спрямо другите токени.
Трансформърът има механизъм на внимание (attention): за всеки токен той пресмята колко да „гледа“ към всеки от предишните. Така в „Иван даде книгата на Мария, защото тя я поиска“ моделът свързва „тя“ с Мария, а „я“ с книгата.
Параметрите са числата (теглата) в мрежата, които се настройват при обучението. Малките модели имат няколко милиарда, най-големите стотици милиарди. Компаниите често не казват точния брой.
Колко текст може да „държи наум“ моделът наведнъж се нарича контекстен прозорец. При днешните модели това са от няколко хиляди до над милион токена.
Как се „учи“ един модел
Обучението става на три стъпки.
Първата е предварителното обучение. Моделът получава трилиони токени текст и милиарди пъти играе една и съща игра: скриват му следващата дума, той познава, проверява се колко е сбъркал и всичките му числа се побутват малко в правилната посока. Това отнема месеци на хиляди специални видеокарти в огромни центрове за данни и струва десетки, дори стотици милиони долари.
Втората е донастройката. Моделът се учи от примери на добри въпроси и отговори, за да стане полезен събеседник, а не просто машина, която довършва текст.
Третата е обратната връзка от хора. Хора оценяват кой от два отговора е по-добър, по-верен и по-безопасен, и моделът се настройва да дава повече от добрите.
След това моделът е „замразен“. Когато си говориш с него, той не се учи от теб в реално време. Разговорът ти не променя самия модел. Някои компании обаче могат да използват разговорите за обучение на следващите версии, затова провери настройките за поверителност на услугата, която ползваш.
🔧 За техниците: Обучение и използване не са едно и също
Обучението (training) е скъпо, защото изчислява грешката и я разпространява назад през всички слоеве (backpropagation), и така за всеки пример от трилиони токени. Използването (inference) е много по-евтино: моделът само минава напред през мрежата, по веднъж за всеки нов токен.
Затова един модел може да се обучава в център за данни за милиони, а после да работи дори на домашен компютър, ако е достатъчно малък.
Знанията на модела спират до датата, на която са събрани данните за обучението. За по-нови неща той или не знае, или ползва търсене в интернет, ако услугата му го дава.
Защо понякога „лъже“ уверено
Тук е най-важното за всеки, който ползва изкуствен интелект. Моделът е научен да дава правдоподобен текст, а не непременно верен. Обикновено двете съвпадат. Понякога обаче моделът съчинява дата, цитат, закон или книга, които не съществуват, и го казва със същата увереност. Това се нарича „халюцинация“.
Затова:
- Проверявай всичко важно: здраве, пари, закони, документи, дати.
- Питай за източници и отвори източниците сам.
- Не приемай отговора като присъда. Приемай го като чернова от бърз, начетен, но понякога разсеян помощник.
На какви машини работи
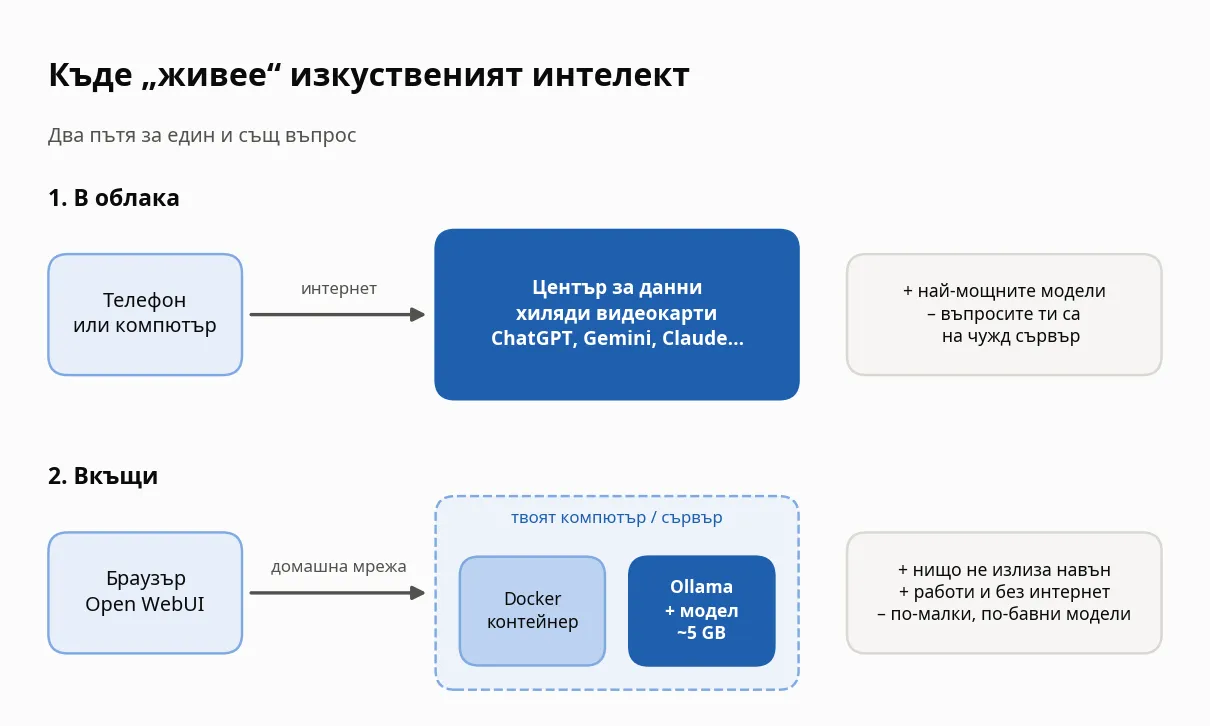
Когато пишеш на ChatGPT, Gemini, Claude или Copilot в телефона, моделът не е в телефона ти. Текстът ти пътува по интернет до огромен център за данни. Там стоят хиляди сървъри със специални видеокарти, всяка от които струва колкото лека кола. Отговорът се пресмята там и се връща при теб.
Това има две страни. Добрата е, че получаваш най-мощните модели на евтин телефон. Другата е, че всичко, което напишеш, минава през сървърите на чужда фирма. Затова не пиши там пароли, ЕГН, номера на карти и лични данни на други хора.
Има и друг път: модели с отворени тегла. Някои компании, например Meta (Llama), Google (Gemma), Mistral от Франция и китайските Qwen и DeepSeek, пускат свободно самите модели. Свалят се като файл и могат да работят на твоя компютър, без интернет и без никой да вижда какво питаш.
Колко силна машина трябва? Малък модел със 7 до 8 милиарда параметъра, „компресиран“ до 4 бита, заема около 5 GB и работи на обикновен компютър с 16 GB памет, дори без видеокарта, само по-бавно. Модел със 70 милиарда параметъра вече иска около 40 GB и сериозна видеокарта.
Пример от вкъщи: на домашния сървър в Кнежа, на който работи и този сайт, върви модел със 7 милиарда параметъра (4,7 GB) на процесор, произведен през 2017 г. Не е бърз като ChatGPT, но отговаря, и то без да праща нищо навън.
Какво е Docker и защо всички го споменават
Ако си търсил как да пуснеш изкуствен интелект у дома, почти сигурно си срещнал думата Docker. Ето какво е с прости думи.
Представи си корабен контейнер. Вътре е подредено всичко, което трябва на една програма: самата програма, библиотеките ѝ, настройките. Контейнерът е еднакъв, независимо дали е натоварен на кораб, на влак или на камион. По същия начин Docker контейнерът тръгва еднакво на всеки компютър: на лаптопа ти, на сървър вкъщи или в облака.
Защо е удобно за изкуствен интелект? Защото програмите около моделите имат много зависимости, точни версии и настройки. С Docker не ги инсталираш една по една. Пускаш един готов контейнер с една команда, а ако нещо се обърка, го махаш, без да си развалиш компютъра.
Най-често срещаната двойка за домашен изкуствен интелект е:
- Ollama: програмата, която сваля моделите и ги пуска да работят.
- Open WebUI: страница в браузъра, която изглежда почти като ChatGPT, но говори с твоя модел вкъщи.
Без Docker също може: Ollama и LM Studio имат и обикновени инсталатори за Windows, Mac и Linux. Docker е по-удобен, когато искаш всичко да работи постоянно на домашен сървър.
🔧 За техниците: Изкуствен интелект у дома с Docker: команди
Пускане на Ollama в контейнер (само с процесор):
docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollamaС видеокарта NVIDIA (трябва предварително NVIDIA Container Toolkit):
docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollamaСваляне и пускане на малък модел, с разговор направо в терминала:
docker exec -it ollama ollama run llama3.2Страница като ChatGPT в браузъра (Open WebUI), която намира Ollama на същия компютър:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:mainПосле отваряш http://localhost:3000 в браузъра. Томовете (-v) пазят моделите и разговорите, когато обновиш или изтриеш контейнера.
Внимание: не отваряй порт 11434 към интернет. Ollama няма парола и всеки, който го намери, ще ползва компютъра ти.
Ще унищожи ли човечеството?
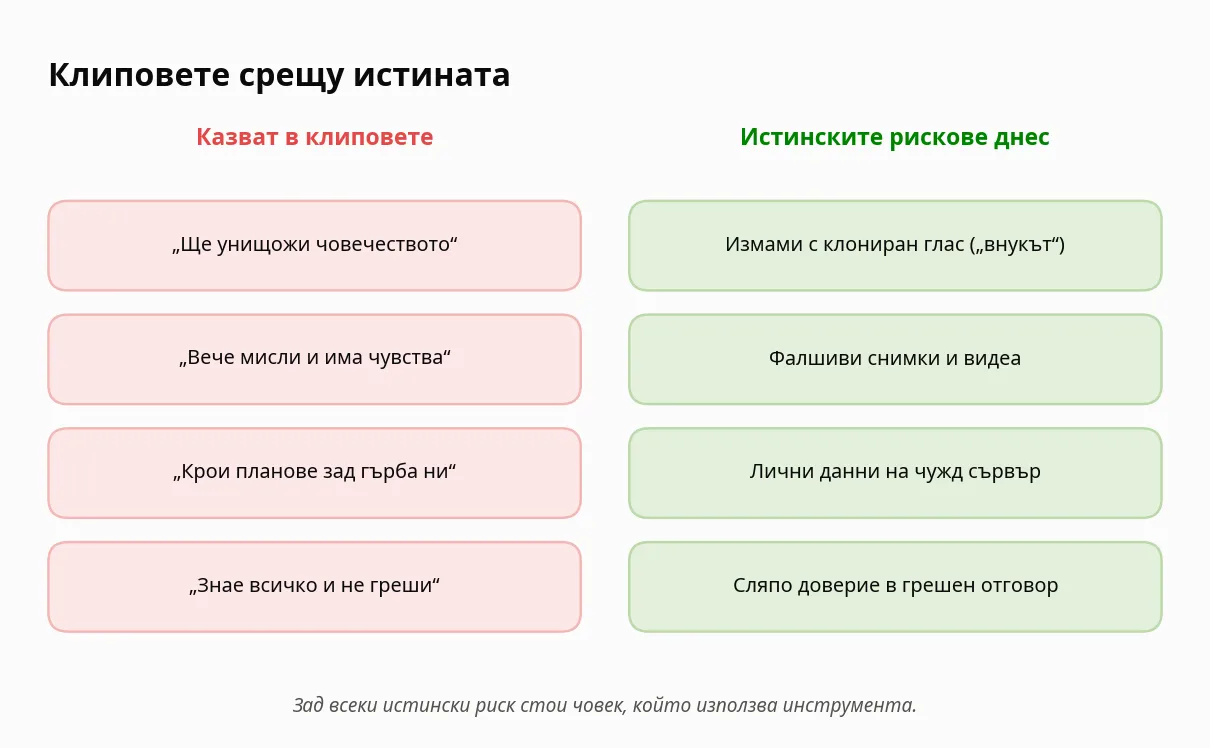
Сега за страшните клипове. Днешните езикови модели нямат собствени цели, воля или желания. Те не „седят“ някъде и не кроят планове. Моделът е файл с числа. Той прави нещо само когато някой му зададе въпрос, и спира веднага щом отговори.
Когато в клип видиш „изкуственият интелект заплаши инженер“ или „отказа да бъде изключен“, почти винаги става дума за изпитание. Изследователи нарочно му задават нагласен сценарий, за да видят какво би направил, и го описват открито, за да оправят проблема. Клиповете показват само страшното заглавие и пропускат останалото.
Това не значи, че няма за какво да внимаваме. Истинските рискове днес са по-приземени, и зад всички стои човек:
- Измамници клонират глас и се обаждат на баба: „Аз съм, внукът ти, трябват ми пари“. Ако се обади близък и иска пари спешно, затвори и му звънни сам на номера, който знаеш.
- Фалшиви снимки и видеа на известни хора, които „препоръчват“ инвестиции или лекарства.
- Лични данни, споделени с чат, който ги пази на чужд сървър.
- Сляпо доверие в отговор, който е грешен.
- Промени в работата. Някои задачи ще се правят от машина, точно както при появата на трактора, компютъра и интернет.
Сериозни учени спорят и за по-далечни рискове, когато системите станат много по-способни. Затова Европейският съюз прие през 2024 г. Закона за изкуствения интелект, първите големи правила за тези системи в света. Това е нормално. И за колите има правила, колан и техническа проверка, но никой не казва, че колата ще унищожи човечеството.
Продължение на мозъка: как да го ползваш умно
Да се върнем на инструмента. Добрият майстор не се страхува от бормашината. Учи се да я държи правилно и знае за какво не става. Същото е и тук.
За какво е полезен още днес:
- Да обясни просто нещо сложно: договор, медицински термин, урок по химия. После все пак питаш лекаря или учителя.
- Да напише чернова на писмо, молба до общината или обява, която после ти оправяш.
- Да преведе текст от и на чужд език.
- Да подреди идеи, да състави списък, да планира ремонт или пътуване.
- Да помогне при учене: „обясни ми го като на 12-годишен“, „задай ми 5 въпроса да се проверя“.
- Да напише или поправи програма, таблица в Excel, формула.
Как да получиш по-добър отговор:
- Кажи кой си и какво искаш: „Аз съм техник, обясни ми за клиент без технически познания…“
- Дай подробности: колко дълго, за кого, в какъв тон.
- Ако отговорът не става, кажи му какво да поправи, вместо да започваш отначало.
- Проверявай фактите. Помощникът е бърз, но не е непогрешим.
- Не му давай пароли, ЕГН и лични данни.
Изкуственият интелект няма да мисли вместо нас. Но човек, който знае как да го ползва, ще свърши повече от човек, който се страхува от него. Точно както преди сто години един майстор с електрическа бормашина пробиваше повече дупки от майстор с ръчно свредло.
Тази статия също е подготвена с помощта на изкуствен интелект и после проверена и подредена от човек. Точно така, както е редно да се ползва един инструмент.